
Los avances fenomenales en la catalogación de la variación genética humana se explican fundamentalmente por la convergencia de varias transformaciones tecnológicas y conceptuales que modificaron de manera profunda la genética médica. La posibilidad de secuenciar simultáneamente grandes cantidades de ácido desoxirribonucleico, comparar millones de posiciones genómicas entre individuos, almacenar los resultados en infraestructuras computacionales de gran escala y relacionarlos con información clínica estructurada hizo posible pasar de una genética basada principalmente en genes y variantes individuales a una genética sustentada en catálogos poblacionales, bases de datos clínicas, repositorios de fenotipos y sistemas integrados de interpretación. La revisión de las bases de datos de genotipo y fenotipo muestra que la expansión de la secuenciación hacia paneles de numerosos genes, exomas y genomas completos convirtió estas bases de datos en componentes esenciales para determinar la relevancia médica de las variantes identificadas en cada individuo.
La magnitud del cambio se comprende al comparar la genética médica anterior con la situación actual. Durante buena parte de la era molecular, la caracterización de una variante requería localizarla mediante estudios familiares, secuenciar un gen candidato, revisar manualmente la literatura y determinar si existían observaciones independientes que relacionaran la variante con una enfermedad. Este procedimiento era especialmente difícil cuando se trataba de enfermedades raras, variantes nuevas o alteraciones con efectos fenotípicos variables. La aparición de la secuenciación masivamente paralela modificó radicalmente el problema porque permitió identificar simultáneamente un número extraordinariamente elevado de variantes en cada individuo; el desafío dejó de ser únicamente descubrir variantes y pasó a ser determinar cuáles de ellas eran relevantes para el fenotipo observado. Esta transformación fue identificada tempranamente como una de las principales razones para desarrollar bases de datos capaces de integrar variación genética, frecuencia poblacional, información clínica y evidencia experimental.
La secuenciación masiva fue particularmente importante porque reveló que cada individuo humano posee una cantidad considerable de variación genética. Una proporción importante de esas diferencias corresponde a variantes benignas que forman parte de la diversidad normal de la especie humana. Por consiguiente, encontrar una variante poco frecuente en una persona afectada no demuestra por sí mismo que dicha variante sea patogénica. Para interpretar correctamente un resultado genómico es necesario conocer si la variante aparece en individuos sanos, con qué frecuencia aparece en diferentes poblaciones, qué efecto molecular puede producir, si se ha observado anteriormente en personas afectadas, si se segrega con la enfermedad dentro de las familias y si existen estudios funcionales que respalden una alteración biológica. Las bases de datos de variación poblacional y de correlaciones genotipo-fenotipo se desarrollaron precisamente para proporcionar gran parte de esta información.
Uno de los cambios más importantes fue la creación de grandes catálogos de variación genética observada en poblaciones humanas. El Genome Aggregation Database constituye un ejemplo paradigmático porque integró datos de secuenciación de 125,748 exomas y 15,708 genomas, correspondientes en conjunto a 141,456 individuos. Esta magnitud permitió estimar con mucha mayor precisión la frecuencia de variantes y estudiar qué genes muestran una reducción marcada de variantes que probablemente inactivan sus productos proteicos. El análisis de estas variantes permitió establecer medidas de restricción mutacional que proporcionan información sobre la tolerancia de los genes humanos a determinadas clases de alteraciones.
La importancia de disponer de una muestra poblacional de gran tamaño reside en que las variantes raras requieren cantidades muy grandes de datos para ser interpretadas. Una variante observada una sola vez en una colección pequeña puede parecer extraordinariamente infrecuente, pero puede resultar relativamente común cuando se estudian cientos de miles de cromosomas. De manera inversa, una variante ausente de una gran base de datos poblacional puede adquirir mayor plausibilidad como candidata a enfermedad, especialmente cuando se encuentra en un gen relacionado con el fenotipo y existe evidencia adicional de patogenicidad. La ausencia poblacional, sin embargo, no constituye por sí misma una demostración de causalidad, porque depende de la cobertura de secuenciación, del tamaño y composición de la población estudiada, de la calidad de los datos y de la naturaleza de la enfermedad.
Las bases de datos poblacionales aportaron además una forma de distinguir entre variación humana frecuente y variantes potencialmente deletéreas. El análisis de 141,456 individuos permitió identificar cientos de miles de variantes predichas como de pérdida de función y estudiar su distribución entre genes. Los genes esenciales o sometidos a una fuerte restricción evolutiva presentan una menor tolerancia a determinadas variantes funcionalmente disruptivas. Esta información puede utilizarse posteriormente como evidencia indirecta para priorizar variantes candidatas en pacientes con enfermedades genéticas.
El segundo gran avance consistió en catalogar de manera sistemática las relaciones entre variantes genéticas y enfermedades. ClinVar constituye uno de los ejemplos fundamentales de este proceso. Se desarrolló como un archivo público destinado a almacenar informes sobre la relación entre variantes genómicas clínicamente relevantes y fenotipos, junto con las interpretaciones de significado clínico y la evidencia que sustenta dichas interpretaciones. La estructura del sistema permite conservar las contribuciones de diferentes laboratorios, investigadores y grupos de expertos, agregarlas cuando corresponden a la misma combinación variante-enfermedad y mostrar explícitamente los casos en los que existen interpretaciones discordantes.
La existencia de ClinVar representa un cambio conceptual importante porque transforma el conocimiento clínico disperso en un recurso reutilizable. Antes de estos repositorios, un laboratorio que identificaba una variante podía disponer solamente de la información que había recopilado internamente o de la literatura científica que conseguía localizar. La disponibilidad de un archivo público permite comparar el hallazgo de un paciente con observaciones procedentes de múltiples instituciones. De esta manera, una variante que inicialmente parece incierta puede adquirir evidencia adicional cuando otros pacientes, laboratorios o grupos de investigación han observado la misma alteración en asociación con el mismo trastorno.
Una característica particularmente importante de este modelo es que las bases de datos modernas no deben limitarse a proporcionar una clasificación final, sino que deben conservar la evidencia utilizada para llegar a esa clasificación. ClinVar mantiene información sobre el remitente, la variante, la condición clínica, la interpretación y los datos que respaldan la interpretación. También conserva diferentes envíos realizados por distintos grupos y permite identificar situaciones de concordancia o conflicto. Este diseño es fundamental porque una clasificación de variante no es una propiedad abstracta e inmutable de la secuencia, sino una conclusión que puede modificarse cuando aparece nueva evidencia científica.
La acumulación de observaciones independientes es uno de los mecanismos que explica por qué estas bases de datos pueden aumentar progresivamente su valor científico. Una variante rara puede ser observada inicialmente en una única familia y permanecer como variante de significado incierto. Posteriormente, otro grupo puede identificarla en una segunda familia con un fenotipo semejante, mientras que un tercer grupo puede demostrar experimentalmente que altera la función del producto génico. La integración de esas observaciones puede convertir una asociación inicialmente débil en una relación genotipo-fenotipo mucho más convincente. Las bases de datos proporcionan la infraestructura necesaria para conservar y combinar estas observaciones a lo largo del tiempo.
La correlación genotipo-fenotipo depende, además, de que tanto el genotipo como el fenotipo puedan representarse de manera precisa y comparable. Esta necesidad originó un tercer avance fundamental: la estandarización de los términos utilizados para describir las variantes y las características clínicas. Una misma enfermedad puede recibir denominaciones diferentes en distintos hospitales, publicaciones o países, y una misma característica clínica puede describirse mediante numerosas expresiones lingüísticas. Sin normalización, la información contenida en miles de registros permanecería fragmentada y sería difícil de comparar mediante métodos computacionales.
El Human Phenotype Ontology fue desarrollado precisamente para proporcionar una representación computacional estandarizada de las anomalías fenotípicas humanas. Desde su creación se ha convertido en un estándar internacional para el intercambio de información fenotípica y ha ampliado progresivamente su cobertura hacia numerosas áreas médicas, entre ellas neurología, nefrología, inmunología y neumología. La existencia de una terminología fenotípica estructurada permite transformar descripciones clínicas complejas en conceptos que pueden ser comparados entre pacientes, enfermedades y genes.
La utilidad de esta estandarización puede entenderse mediante un ejemplo conceptual. Un paciente puede presentar retraso del desarrollo, convulsiones, alteraciones del crecimiento y una anomalía ocular. Si cada característica se registra únicamente como texto libre, comparar ese paciente con miles de pacientes de diferentes hospitales requiere una interpretación manual considerable. Si las mismas características se representan mediante términos estandarizados de una ontología fenotípica, los sistemas computacionales pueden identificar automáticamente otros individuos que comparten combinaciones similares de características. Esta posibilidad permite priorizar genes y variantes incluso cuando la enfermedad todavía no ha sido diagnosticada. La literatura metodológica sobre priorización de variantes ha demostrado que la similitud fenotípica puede utilizarse como elemento para orientar la interpretación de variantes en enfermedades raras no resueltas.
La integración de fenotipo y genotipo es particularmente poderosa en las enfermedades raras porque cada enfermedad individual puede tener muy pocos pacientes conocidos. Una variante extremadamente rara puede parecer imposible de interpretar cuando se observa de manera aislada, pero puede adquirir significado cuando se descubre que varios pacientes no relacionados presentan la misma variante o alteraciones del mismo gen y comparten un conjunto semejante de características clínicas. Esta estrategia de comparación entre individuos permite identificar nuevos genes asociados con enfermedades y reconocer síndromes que anteriormente no estaban definidos. DECIPHER fue creado, en parte, para facilitar precisamente este tipo de comparación.
DECIPHER constituye un ejemplo especialmente claro de cómo la catalogación digital puede transformar una observación clínica individual en conocimiento colectivo. La plataforma comenzó orientándose hacia desequilibrios cromosómicos submicroscópicos, debido a que muchas deleciones y duplicaciones eran extremadamente raras y difíciles de interpretar. Cuando se identificaban pacientes diferentes que compartían una alteración genómica y características fenotípicas semejantes, aumentaba la evidencia de que la alteración tenía relevancia patogénica y podía definirse un nuevo síndrome.
El desarrollo posterior de DECIPHER amplió este modelo hacia variantes de secuencia, variantes de número de copias y otros tipos de variación genética. La plataforma comenzó a integrar datos procedentes de múltiples recursos bioinformáticos y a proporcionar herramientas para visualizar variantes, genes, regiones cromosómicas y características fenotípicas dentro de un mismo contexto. Esta integración permitió pasar de una simple colección de variantes a un sistema destinado a apoyar activamente la interpretación clínica y la investigación de enfermedades raras.
El crecimiento de estas bases de datos también fue impulsado por la cooperación internacional. Las enfermedades raras plantean un problema estadístico fundamental: una sola institución puede observar muy pocos casos de una determinada enfermedad. La agregación internacional permite aumentar el número de individuos disponibles para comparación y, con ello, mejorar la capacidad para establecer asociaciones entre variantes y fenotipos. DECIPHER, por ejemplo, evolucionó hacia una plataforma internacional que reúne datos de numerosos proyectos y países, manteniendo mecanismos destinados a compartir información fenotípica y genética de pacientes con las salvaguardas correspondientes.
La colaboración internacional también reduce la fragmentación del conocimiento. Una variante genética puede ser descrita bajo diferentes sistemas de nomenclatura, asociada con diferentes nombres de enfermedades o registrada en bases de datos separadas. La integración de recursos permite conectar esas representaciones mediante identificadores estandarizados y relaciones computacionales. El objetivo no consiste solamente en acumular más registros, sino en hacer que registros procedentes de diferentes fuentes puedan reconocerse como representaciones de la misma variante, el mismo gen, la misma enfermedad o características fenotípicas relacionadas.
La normalización de las variantes constituye otro componente esencial. Una misma alteración genética puede describirse de diferentes maneras dependiendo de la secuencia de referencia, la transcripción utilizada, el sistema de coordenadas o la convención de nomenclatura. ClinVar utiliza estándares de representación de variantes y relaciona las variantes con referencias genómicas y conceptos de enfermedad. Esta estandarización permite que una variante observada por un laboratorio pueda compararse con registros generados por otros laboratorios, siempre que la representación corresponda realmente a la misma alteración biológica.
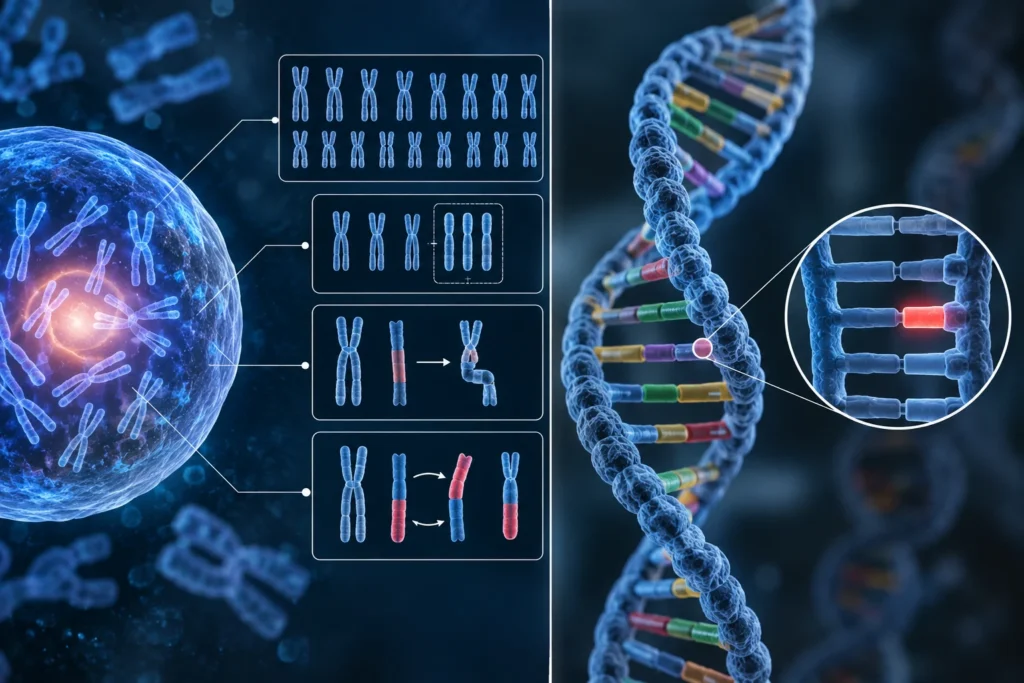
La catalogación de la variación genética también se expandió desde las variantes pequeñas hacia alteraciones genómicas de mayor tamaño. Las variantes estructurales pueden involucrar grandes segmentos de ácido desoxirribonucleico y producir deleciones, duplicaciones, inversiones, inserciones o reordenamientos complejos. Los estudios de referencia sobre variación estructural demostraron que estas alteraciones constituyen una parte importante de la diversidad genómica humana y pueden tener consecuencias profundas en la enfermedad. Por ello, una base de datos moderna de variación genética no puede limitarse a sustituciones de una sola base.
La incorporación de variantes estructurales aumentó considerablemente la complejidad de la correlación genotipo-fenotipo. Una sustitución de un nucleótido puede alterar un aminoácido concreto, mientras que una deleción cromosómica puede eliminar varios genes simultáneamente. La interpretación de esta última requiere determinar qué genes están incluidos, cuáles presentan sensibilidad a la pérdida de una copia, qué elementos reguladores están afectados y si otros individuos con alteraciones semejantes muestran características clínicas comparables. Las bases de datos que integran información estructural, genética y fenotípica permiten realizar este análisis de manera mucho más sistemática.
Otro factor decisivo fue el aumento exponencial de la capacidad de almacenamiento y procesamiento de información. La secuenciación masiva genera cantidades de datos que serían imposibles de analizar eficazmente mediante métodos manuales. Las bases de datos permiten indexar variantes, genes, coordenadas genómicas, enfermedades y fenotipos para que las búsquedas puedan realizarse de manera automática. Además, las interfaces de programación permiten incorporar los datos directamente en programas de análisis, de modo que la consulta de una base de datos puede formar parte de una cadena computacional de interpretación genómica. ClinVar, por ejemplo, proporciona acceso interactivo y acceso programático, lo que facilita su incorporación en sistemas de análisis clínico y de investigación.
La automatización es fundamental porque la cantidad de variantes detectadas mediante secuenciación de exomas o genomas completos puede ser enorme. Un análisis clínico no puede considerar todas esas variantes con el mismo nivel de prioridad. Los sistemas computacionales pueden utilizar información de frecuencia poblacional, consecuencias moleculares, restricción génica, asociaciones conocidas con enfermedades y similitud fenotípica para reducir progresivamente el conjunto de variantes candidatas. La base de datos se convierte así en un componente activo del proceso de interpretación y no simplemente en un archivo pasivo.
La acumulación de datos también permitió mejorar el conocimiento de la función génica. Si un gen presenta una fuerte depleción de variantes de pérdida de función en grandes poblaciones humanas, esto puede indicar que la pérdida completa de su función tiene consecuencias biológicas importantes. Si además ese gen aparece enriquecido entre pacientes con determinada enfermedad, la convergencia de ambas líneas de evidencia aumenta su interés como candidato. Los análisis de restricción mutacional realizados con grandes bases de datos poblacionales demostraron que la variación natural del genoma puede utilizarse para inferir propiedades funcionales de los genes humanos.
La información poblacional también ayuda a interpretar la plausibilidad de una variante en función de la frecuencia esperada de una enfermedad. Si una variante supuestamente responsable de una enfermedad genética grave y altamente penetrante aparece con una frecuencia demasiado elevada en una población general no seleccionada, su capacidad para explicar por sí sola esa enfermedad puede ponerse en duda. Este principio de compatibilidad entre frecuencia alélica y prevalencia de enfermedad constituye una de las herramientas fundamentales de la interpretación de variantes. Su aplicación requiere, sin embargo, bases de datos poblacionales suficientemente grandes y representativas, además de una comprensión adecuada de la penetrancia y de la arquitectura genética de la enfermedad.
Las bases de datos también permitieron reconocer que el mismo gen puede producir diferentes fenotipos y que una misma variante puede estar asociada con más de una condición clínica. ClinVar, por ejemplo, estructura la información alrededor de las relaciones entre variantes y condiciones, de modo que una variante puede aparecer en diferentes registros cuando ha sido evaluada para distintas enfermedades. Esta característica resulta importante porque la relación entre genotipo y fenotipo no siempre es uno a uno. La pleiotropía, la penetrancia incompleta, la expresividad variable y los efectos dependientes del contexto hacen que la interpretación genética requiera considerar múltiples posibles relaciones.
La penetrancia constituye precisamente uno de los motivos por los cuales la correlación genotipo-fenotipo no puede reducirse a una asociación binaria. La presencia de una variante patogénica no necesariamente implica que todas las personas portadoras presentarán exactamente el mismo fenotipo. Algunas variantes presentan penetrancia incompleta, mientras que otras muestran expresividad variable. La comparación de numerosos individuos portadores permite observar estas diferencias y determinar con mayor precisión qué características son frecuentes, cuáles son variables y qué factores pueden modificar la expresión clínica. Las bases de datos fenotípicas proporcionan el volumen de observaciones necesario para estudiar estas relaciones.
La catalogación también permite estudiar la relación entre variantes genéticas y edad de aparición, gravedad y espectro clínico. Una misma alteración molecular puede producir manifestaciones tempranas en algunos individuos y tardías en otros, o afectar diferentes órganos con intensidades diferentes. Cuando los registros contienen información fenotípica detallada y longitudinal, es posible analizar la distribución de esas características entre múltiples portadores. Esta información puede ser clínicamente importante porque permite pasar de una afirmación general acerca de que una variante está relacionada con una enfermedad a una descripción mucho más precisa del fenotipo asociado.
La calidad de los datos fenotípicos constituye, sin embargo, una de las principales limitaciones. La revisión de las bases de datos de genotipo-fenotipo ha señalado que el volumen y la calidad de la información fenotípica han sido históricamente inferiores a los correspondientes a los datos genéticos. Esto se debe a que obtener un genoma es cada vez más automatizable, mientras que describir exhaustivamente el fenotipo requiere evaluación clínica, seguimiento temporal, recursos especializados y una terminología coherente. Además, existen dificultades éticas, jurídicas, económicas y organizativas relacionadas con la recopilación y el intercambio de información clínica.
Por esta razón, el progreso de la genómica médica no depende únicamente de secuenciar más individuos, sino también de caracterizarlos mejor. Un genoma sin información clínica suficiente puede permitir conocer la existencia de una variante, pero no necesariamente permite establecer su relación con una enfermedad. De manera inversa, un registro clínico detallado sin una caracterización genómica adecuada puede dificultar la identificación de la causa molecular. La máxima utilidad aparece cuando ambas dimensiones se encuentran integradas y pueden analizarse mediante estándares comunes.
La evolución de las bases de datos ha llevado además a una transición desde repositorios aislados hacia ecosistemas interconectados. ClinVar puede relacionarse con recursos que describen variantes y condiciones; las bases poblacionales proporcionan frecuencias y características de la variación; DECIPHER conecta variantes con fenotipos; y las ontologías fenotípicas permiten que las características clínicas puedan ser comparadas computacionalmente. Esta interconexión convierte la información distribuida en una red de conocimiento en la que cada nueva observación puede aportar valor a interpretaciones realizadas previamente.
El concepto de descubrimiento de datos se volvió especialmente importante en este contexto. Las bases de datos contemporáneas no solo deben almacenar información, sino permitir encontrar relaciones que no eran evidentes cuando cada registro fue generado. Una búsqueda puede comenzar con una variante, continuar hacia el gen, extenderse hacia enfermedades asociadas y terminar en pacientes que comparten un conjunto de características fenotípicas. También puede realizarse el proceso inverso: comenzar con un conjunto de signos clínicos, identificar fenotipos similares en otros pacientes, localizar genes asociados y finalmente priorizar variantes. La arquitectura moderna de las bases de datos está diseñada para permitir ambos sentidos de exploración.
El emparejamiento de pacientes constituye una consecuencia especialmente poderosa de esta integración. Cuando dos individuos con una enfermedad no diagnosticada comparten una variante rara en el mismo gen y presentan fenotipos semejantes, la coincidencia puede proporcionar evidencia que ninguno de los casos individuales podía generar por sí solo. DECIPHER utiliza información fenotípica estructurada y datos de variantes para facilitar este tipo de coincidencias entre pacientes. Esta estrategia ha contribuido al reconocimiento de genes asociados con enfermedades raras y a la resolución diagnóstica de casos que previamente permanecían sin explicación molecular.
El valor de estas bases de datos aumenta además con el tiempo. Una base de datos genética es un sistema dinámico porque la interpretación de las variantes puede cambiar cuando se publican nuevos estudios, aparecen nuevos pacientes, se desarrollan ensayos funcionales o se modifican los criterios de clasificación. ClinVar conserva versiones y diferentes interpretaciones remitidas por las organizaciones participantes, lo que permite mantener un registro histórico de cómo ha evolucionado el conocimiento sobre una variante. Esta característica resulta esencial para la medicina genómica porque un resultado considerado incierto en el momento del diagnóstico puede adquirir posteriormente una interpretación diferente.
La naturaleza dinámica del conocimiento genético también explica por qué la interpretación de variantes debe considerarse un proceso continuo. La identificación de una variante en un paciente representa solamente el comienzo del análisis. Posteriormente pueden aparecer datos poblacionales que modifiquen la estimación de su frecuencia, estudios funcionales que aclaren su efecto molecular, nuevas familias afectadas que aporten evidencia de segregación o nuevos pacientes con fenotipos similares. Las bases de datos permiten incorporar estas observaciones progresivamente y convertir el conocimiento acumulado en una herramienta de reinterpretación.
La catalogación de la variación genética también ha modificado la investigación de enfermedades complejas. Aunque las correlaciones genotipo-fenotipo son particularmente evidentes en enfermedades monogénicas y raras, los grandes conjuntos de datos poblacionales permiten estudiar asociaciones entre variantes comunes, rasgos cuantitativos y enfermedades multifactoriales. Los estudios de asociación de genoma completo dependen de grandes cantidades de individuos para detectar efectos genéticos que individualmente pueden ser pequeños. La disponibilidad de grandes colecciones de variantes y fenotipos ha hecho posible analizar simultáneamente millones de posiciones genómicas y numerosos fenotipos.
La base de datos deja de ser exclusivamente una herramienta diagnóstica y se convierte también en una plataforma para investigar mecanismos biológicos. Si determinadas variantes se asocian consistentemente con una enfermedad, pueden señalar genes, vías moleculares o procesos fisiológicos relevantes. Posteriormente, la información puede integrarse con datos de expresión génica, proteínas, metabolitos, regulación epigenética y otros niveles de organización biológica. La genómica contemporánea utiliza así la correlación entre genotipo y fenotipo como punto de partida para reconstruir mecanismos causales más amplios.
El crecimiento de los catálogos genéticos también ha permitido utilizar la variación humana natural como una forma de experimento biológico. Las personas que portan variantes que reducen o eliminan la función de determinados genes pueden proporcionar información sobre las consecuencias de modificar esas funciones en seres humanos. El análisis de variantes de pérdida de función en grandes poblaciones ha permitido identificar genes sometidos a fuerte restricción y estudiar la posible importancia terapéutica de determinadas rutas biológicas. Esta estrategia ha contribuido incluso a la identificación y validación de posibles dianas farmacológicas.
Otro avance fundamental fue la incorporación de datos de ancestría y diversidad poblacional. Las frecuencias de las variantes no son idénticas en todas las poblaciones humanas y los patrones de variación pueden diferir considerablemente entre grupos. Una base de datos construida a partir de una población limitada puede, por tanto, proporcionar una representación incompleta de la diversidad genética humana. La incorporación de individuos con diferentes ancestrías permite mejorar la estimación de frecuencias, reducir errores de interpretación y aumentar la capacidad para identificar variantes relevantes en poblaciones históricamente subrepresentadas.
La diversidad poblacional es especialmente importante para distinguir variantes raras de variantes comunes. Una variante que es extremadamente infrecuente en una población puede ser relativamente frecuente en otra debido a la historia demográfica, deriva genética, selección natural o efectos fundadores. Si una base de datos no representa adecuadamente esta diversidad, una variante benigna puede clasificarse erróneamente como excepcionalmente rara. Por ello, las bases de datos poblacionales deben interpretarse teniendo en cuenta la composición ancestral de sus participantes y la representación diferencial de las poblaciones humanas.
El crecimiento de los datos no elimina la incertidumbre; en algunos aspectos, la hace más visible. Las bases de datos pueden contener interpretaciones discordantes para una misma variante porque diferentes grupos pueden evaluar de manera distinta la evidencia disponible. Esta discordancia no necesariamente representa un fracaso de la base de datos. Por el contrario, conservar explícitamente los conflictos permite identificar áreas en las que la evidencia científica todavía es insuficiente o en las que es necesario revisar criterios de clasificación. ClinVar fue diseñado para mostrar precisamente estas situaciones y distinguir entre diferentes niveles de revisión, incluidas evaluaciones realizadas por grupos expertos.
También es importante comprender que una base de datos no transforma automáticamente una asociación estadística en causalidad. Una correlación entre una variante y una enfermedad puede deberse a diferentes mecanismos, incluyendo desequilibrio de ligamiento, estructura poblacional, sesgos de selección o efectos indirectos. Para establecer una relación causal sólida es necesario integrar diferentes tipos de evidencia, como segregación familiar, observación independiente, frecuencia poblacional, plausibilidad funcional, estudios experimentales y coherencia con el mecanismo conocido de la enfermedad. Las bases de datos facilitan la integración de estas evidencias, pero la interpretación científica continúa requiriendo evaluación crítica.
Por esta razón, el enorme crecimiento de los catálogos genéticos debe entenderse como un incremento de la capacidad para reunir evidencia, no como una sustitución del razonamiento clínico y científico. La información almacenada puede orientar la interpretación, reducir el número de variantes candidatas y proporcionar antecedentes de casos previos, pero la conclusión diagnóstica depende de la integración de todos los datos disponibles. La revisión de las bases de datos de genotipo-fenotipo destaca precisamente que las diferencias en calidad, cobertura, accesibilidad y grado de curación hacen necesario conocer las características de cada recurso antes de utilizarlo como evidencia.
La catalogación digital también hizo posible que el conocimiento producido en una institución pudiera ser reutilizado por otras. Un laboratorio que identifica una variante y aporta información clínica no solamente beneficia al paciente estudiado, sino que puede contribuir a resolver futuros casos que presenten la misma variante. Del mismo modo, un caso clínico que inicialmente no permite establecer una conclusión puede adquirir importancia años después cuando aparece otro paciente con una alteración molecular semejante. Este fenómeno de acumulación colectiva constituye una de las principales razones por las que las bases de datos compartidas tienen un valor científico superior al de colecciones aisladas.
El principio puede expresarse de manera sencilla: cuanto más precisa sea la descripción del genotipo, cuanto más detallada sea la caracterización del fenotipo y cuanto mayor sea el número de individuos comparables, mayor será la capacidad para reconocer patrones biológicamente significativos. Sin embargo, esta relación depende de la calidad de los datos y de su correcta normalización. Un gran volumen de información mal estructurada no necesariamente produce conocimiento útil; el verdadero avance surge cuando grandes cantidades de datos pueden integrarse mediante identificadores comunes, estándares de representación, ontologías, métodos estadísticos y procedimientos de curación.
Los avances fenomenales en la catalogación de la variación genética fueron posibles porque la medicina pasó de disponer de observaciones genéticas relativamente escasas y dispersas a disponer de grandes repositorios digitales que reúnen variantes, frecuencias poblacionales, genes, enfermedades, características fenotípicas, resultados funcionales y evaluaciones clínicas. La secuenciación masiva proporcionó el volumen de datos; la bioinformática permitió procesarlo; las bases poblacionales proporcionaron el contexto para determinar la rareza de las variantes; los archivos clínicos permitieron relacionarlas con enfermedades; las ontologías hicieron comparable la información fenotípica; las plataformas internacionales permitieron encontrar pacientes semejantes; y los sistemas de acceso programático hicieron posible integrar todo ello en los flujos de análisis genómico.
Por ello, las correlaciones genotipo-fenotipo actuales no dependen exclusivamente de la capacidad de observar una variante en un paciente, sino de la capacidad de situar esa variante dentro de un contexto de conocimiento acumulado. Una variante puede interpretarse comparándola con su frecuencia en poblaciones humanas, con otras variantes del mismo gen, con individuos que presentan alteraciones semejantes, con enfermedades asociadas, con características fenotípicas compartidas y con evidencia experimental. La convergencia de estas dimensiones permite transformar una diferencia en la secuencia del ácido desoxirribonucleico en una hipótesis biológica y clínica progresivamente más precisa.
El avance fundamental no consiste simplemente en que existan más bases de datos, sino en que estas han convertido la variación genética humana en un objeto de conocimiento acumulativo, comparativo y dinámico. Cada nuevo individuo secuenciado puede contribuir a conocer la frecuencia de una variante, cada nuevo caso clínico puede aportar información sobre su expresión fenotípica, cada estudio funcional puede modificar la interpretación de su efecto y cada nueva coincidencia entre pacientes puede fortalecer una relación genotipo-fenotipo. De esta manera, la medicina genómica ha desarrollado una infraestructura científica en la que la interpretación de un genoma individual se beneficia de la experiencia acumulada de miles o cientos de miles de individuos previamente estudiados.